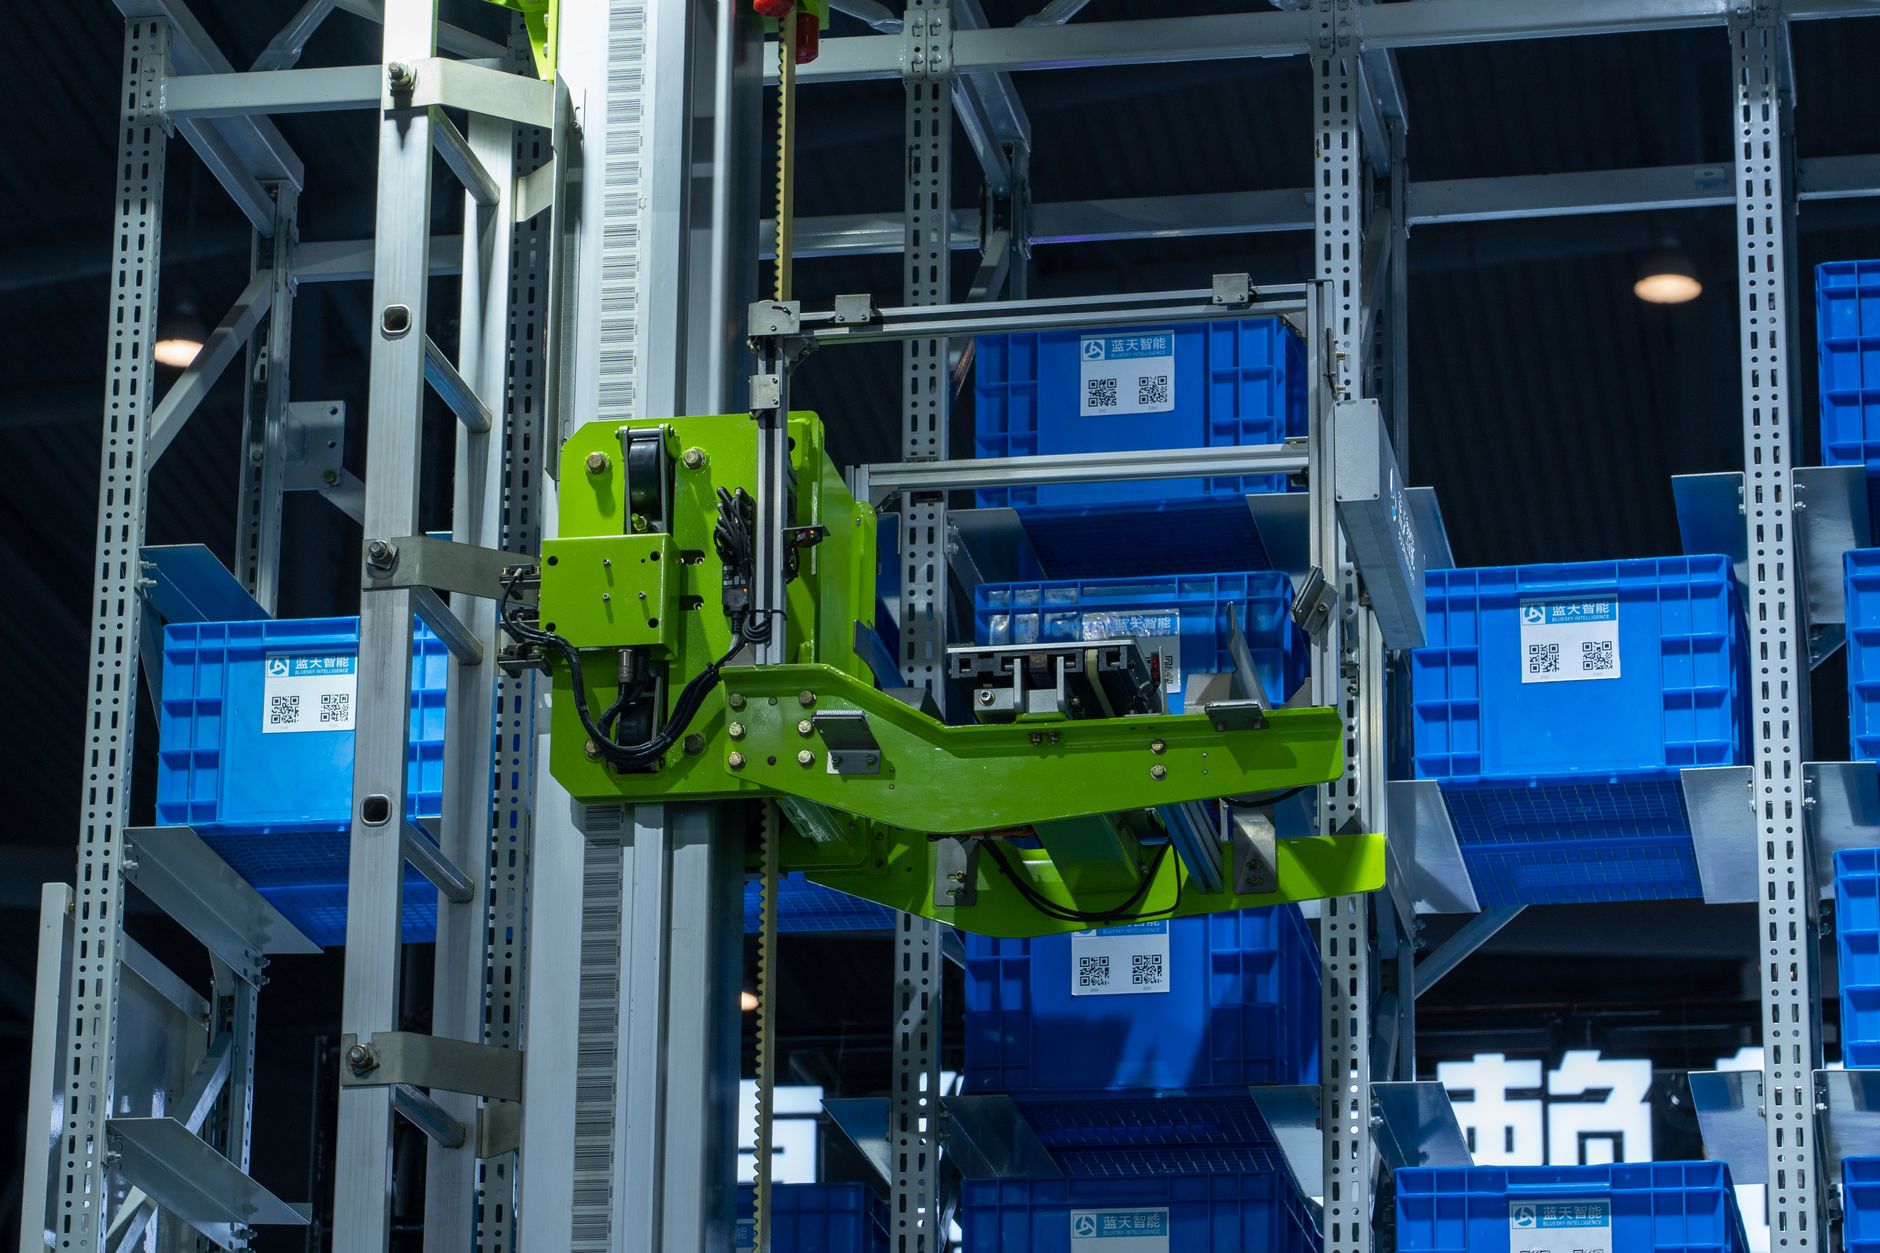


Dlaczego logistyka produkcji jest naturalnym „poligonem” dla AI
Charakter logistyki produkcji: gęsta sieć zależności i ciągła presja
Logistyka produkcji to miejsce, w którym najmniejsze zakłócenie szybko zamienia się w realny koszt. Z pozoru to „tylko” dostarczanie materiałów na czas i wywożenie gotowych wyrobów. W praktyce to gęsta sieć zależności: stany magazynowe komponentów, dostępność narzędzi, przezbrojenia, czasy transportu wewnętrznego, awaryjność maszyn, dostępność operatorów, plany produkcyjne klientów.
Każda zmiana w jednym punkcie tej sieci wywołuje konsekwencje gdzie indziej. Spóźniony komponent blokuje całą linię. Zbyt wczesna dostawa zajmuje miejsce, generuje dodatkowe przeładunki i zwiększa ryzyko pomyłek. Źle zaplanowane przezbrojenia wydłużają przestoje i wymuszają nadgodziny. Taki krajobraz sprawia, że logistyka produkcji jest idealnym obszarem do wykorzystania sztucznej inteligencji, bo klasyczne, ręczne planowanie i analiza arkuszy kalkulacyjnych zwyczajnie nie nadążają za dynamiką zdarzeń.
Presja kosztowa dokłada kolejną warstwę: rosnące ceny energii, wynagrodzeń, materiałów, a jednocześnie presja na krótsze czasy realizacji i mniejsze serie. W tej sytuacji „dokręcanie śrubki” ludziom lub kupowanie kolejnych wózków widłowych daje coraz mniejszy efekt. Natomiast inteligentniejsze sterowanie tym, co już istnieje – za pomocą AI – potrafi znacząco obniżyć koszty bez drastycznych inwestycji.
Dane istnieją – ale rzadko pracują na wynik
Większość fabryk ma już całkiem sporo danych: logi z maszyn, raporty OEE, zapisy w systemach ERP i MES, informacje o zleceniach, ruchach magazynowych, transportach wewnętrznych, reklamacjach jakościowych. Problem nie polega na ich braku, tylko na tym, że są rozproszone, niespójne i wykorzystywane głównie raportowo, a nie decyzyjnie.
Typowy obraz: osobno żyje ERP (planowanie i księgowość), osobno MES (produkcja i raportowanie), osobno CMMS (utrzymanie ruchu), osobno Excelle logistyki i utrzymania ruchu, a część wiedzy funkcjonuje wyłącznie w głowach brygadzistów. Człowiek jest w stanie ogarnąć kilka takich źródeł jednocześnie, ale kiedy trzeba podjąć kilkadziesiąt decyzji dziennie, przy szybko zmieniających się warunkach, intuicja przestaje wystarczać.
AI sprawdza się tu nie dlatego, że jest „modna”, ale dlatego, że potrafi na bieżąco łączyć dane z różnych systemów, wychwytywać nieoczywiste zależności i proponować działania, zanim problem stanie się widoczny na hali: spóźniony transport, rosnące ryzyko awarii, brak części zamiennej, nieoptymalne sekwencje zleceń produkcyjnych.
Gdzie ucieka najwięcej pieniędzy: ciche dreny marży
W logistyce produkcji największe straty rzadko są spektakularne. Bardziej przypominają powolne krwawienie niż jednorazową katastrofę. Kilka głównych obszarów:
- Przestoje – zarówno duże awarie, jak i setki mikroprzestojów, które pojedynczo wydają się nieistotne, ale w skali miesiąca pochłaniają dziesiątki godzin pracy.
- Nadprodukcja i zbędne zapasy – produkowanie „na magazyn” i trzymanie komponentów „na wszelki wypadek” zamraża pieniądze i generuje dodatkowe koszty składowania, kompletacji, kontroli jakości.
- Nieefektywne harmonogramy – zbyt częste przezbrojenia, złe sekwencje zleceń, niedoszacowane czasy operacji, brak synchronizacji z dostępnością materiałów i narzędzi.
- Chaos w logistyce wewnętrznej – kursujące wózki z „gorącymi” paletami, szukanie brakującego pojemnika, dublowanie transportów, wąskie gardła na korytarzach i rampach.
AI pozwala uderzać dokładnie w te ciche dreny marży, bo potrafi zidentyfikować, które przestoje są naprawdę krytyczne, które zapasy są ewidentnie przewymiarowane, a które trasy transportu wewnętrznego generują najwięcej strat czasu i energii.
Dlaczego „automatyzujmy wszystko” przegrywa z „uderz w 2–3 wąskie gardła”
Popularna, ale ryzykowna ścieżka to wielki projekt „transformacji cyfrowej”: z góry założony, szeroki program automatyzacji i wdrożeń AI „wszędzie, gdzie się da”. Brzmi ambitnie, ale w praktyce często kończy się rozproszeniem wysiłku i brakiem szybkich, widocznych efektów. Pracownicy na hali widzą przede wszystkim kolejne zmiany, kolejne narzędzia i kolejne raporty, a nie mniejsze przestoje czy mniej nadgodzin.
Bardziej skuteczne podejście to precyzyjny wybór 2–3 wąskich gardeł, które realnie najbardziej bolą: na przykład jedna linia o największym wolumenie, magazyn MRO (części zamiennych) generujący najwięcej „awaryjnych zakupów”, albo strefa transportu wewnętrznego, która najczęściej blokuje się w godzinach szczytu. W tych miejscach AI ma największą szansę przełożyć się szybko na mniejsze przestoje i niższe koszty.
Takie skupienie ma jeszcze jedną zaletę: ułatwia uczenie się organizacji. Zespół widzi, jak wygląda pilotaż, jakie problemy wychodzą przy integracji systemów, jak reagują operatorzy. Można popełnić błędy w skali lokalnej, a dopiero później przenieść dobre praktyki na kolejne obszary, zamiast próbować od razu ogarnąć całą fabrykę.
Krótki przykład: linia montażu i proste modele o dużej wartości
W jednej z fabryk montażu, każdy nieplanowany przestój linii przekładał się na bezproduktywną pracę kilkudziesięciu osób. Przez lata próbowano rozwiązać problem przez „więcej serwisów zapobiegawczych” i zakupy dodatkowych maszyn, ale efekty były umiarkowane. Dopiero zbudowanie niewielkiego modelu AI analizującego dane z czujników i logi awarii pozwoliło zidentyfikować powtarzający się wzorzec: rosnącą wibrację jednego z modułów kilka godzin przed poważniejszym zatrzymaniem.
Nie było tu spektakularnej „rewolucji AI”. Jeden, stosunkowo prosty model, wpięty w istniejące systemy i procedury, zaczął generować rekomendacje krótkich postojów serwisowych w dogodnych oknach produkcyjnych. Efekt? Łączny czas przestojów linii spadł znacząco, bez konieczności wymiany parku maszynowego, a koszty były niższe niż roczne straty z tytułu wcześniejszych awarii.
Jak zacząć: diagnoza obecnego stanu i realnych problemów
Oddzielenie narzekań od twardych problemów
Rozmowy na hali często brzmią podobnie: „ciągle brakuje materiału”, „maszyna znów się psuje”, „wszystko robimy na ostatnią chwilę”. Te sygnały są cenne, ale mają charakter percepcyjny. Zanim pojawi się pomysł na AI, potrzebna jest twarda diagnoza: gdzie dokładnie występują straty, jak często, z jakimi skutkami finansowymi.
Pomaga w tym proste zestawienie:
- narzekanie: „ciągle stoimy” – twardy wskaźnik: liczba i łączny czas przestojów na danej linii, z podziałem na przyczyny,
- narzekanie: „ciągle brakuje części” – twardy wskaźnik: liczba sytuacji, w których niedostępność komponentu opóźniła start zlecenia,
- narzekanie: „ciągle nadgodziny” – twardy wskaźnik: godziny nadliczbowe vs. plan, w korelacji z opóźnieniami i przestojami.
Kiedy narzekania przełożą się na mierzalne problemy, można dopiero sprawdzić, gdzie AI ma realną przestrzeń do zrobienia różnicy. Bez tej wstępnej pracy generatywne pomysły na „algorytmy predykcyjne” kończą w prezentacjach, a nie w realnych zmianach na hali.
Mapa przepływu materiałów i informacji
Kluczowym krokiem jest stworzenie mapy przepływu materiałów i informacji od momentu zamówienia komponentu po wysyłkę wyrobu gotowego. nie chodzi o idealny diagram BPMN, ale o praktyczne spojrzenie: kto, w jakiej kolejności, z jakich systemów korzysta, jakie dane są generowane, gdzie są punkty decyzyjne i gdzie powstają opóźnienia.
Na takiej mapie widać na przykład, że:
- informacja o opóźnieniu dostawy pojawia się tylko w systemie zakupowym, a planista produkcji dostaje ją z opóźnieniem lub „pokątnie”,
- utrzymanie ruchu ma swój własny rejestr awarii, który w ogóle nie jest powiązany z danymi o planie produkcji,
- logistyka wewnętrzna planuje trasy wózków w arkuszu Excel, bez danych z produkcji na żywo.
AI w logistyce produkcji nie polega wyłącznie na „sprytnych modelach”, ale też na wpięciu się w te przepływy. Bez zrozumienia, jak naprawdę płyną informacje i materiały, łatwo stworzyć model, który teoretycznie jest poprawny, lecz w praktyce nie ma dostępu do właściwych danych we właściwym czasie.
Zbieranie danych o przestojach – głębiej niż tylko „czas postoju”
Wiele zakładów rejestruje przestoje na poziomie „ile minut stało”. To za mało, żeby AI mogła nie tylko opisywać, ale i prognozować problemy. Przy każdym przestoju warto gromadzić minimum:
- przyczynę (w miarę standaryzowaną listę, nie tylko „awaria”),
- kontekst – jaki produkt, jaka seria, jaki etap zmiany, jaki operator,
- zdarzenia poprzedzające – alarmy, zmiany parametrów, wcześniejsze mikroprzestoje.
Im lepiej opisane są przestoje, tym łatwiej zbudować modele AI do analizy przyczyn źródłowych i predykcji. Nie oznacza to, że od pierwszego dnia wszystko musi być idealne. Znacznie rozsądniej jest stopniowo doprecyzowywać rejestrację, wprowadzając proste formularze, kody przyczyn, a potem, w miarę rozwoju projektu, zwiększać poziom szczegółowości tam, gdzie dane okazują się naprawdę użyteczne.
Ocena dojrzałości danych: od ERP po zeszyt brygadzisty
Przed skokiem w AI warto przeprowadzić przegląd źródeł danych:
- ERP – zamówienia, stany magazynowe, terminy dostaw, zlecenia produkcyjne,
- MES – realizacja zleceń, czasy operacji, raporty przestojów, OEE,
- CMMS – zgłoszenia awarii, przeglądy, części zamienne,
- arkusze Excel – lokalne planowanie, harmonogramy, listy priorytetów,
- „zeszyty” i tablice – nieformalne systemy, z których korzystają brygadziści.
Każde z tych źródeł ma inną jakość danych. ERP zwykle jest lepiej ustrukturyzowany, ale opóźniony względem rzeczywistości. MES bywa pełen „luk” lub danych wpisywanych „na skróty”. Excelle i zeszyty mają często najbardziej aktualne informacje, ale są nieustrukturyzowane i trudno je zautomatyzować. AI nie wymaga idealnych danych, lecz świadomego obchodzenia się z ich niedoskonałościami.
Dobrym podejściem jest prosta macierz: które dane są krytyczne dla wybranego problemu (np. przestoje na kluczowej linii), gdzie one są przechowywane, jak są kompletne i jak często aktualizowane. Na tej podstawie można podjąć decyzję, czy najpierw ustabilizować zbieranie danych (np. ustandaryzować raportowanie przestojów), czy już da się ruszyć z pilotażem AI i poprawiać jakość danych „w locie”.
Kiedy nie startować z AI: brak fundamentów procesu
Są sytuacje, w których wdrażanie AI w logistyce produkcji jest po prostu przedwczesne, a efekty będą w najlepszym razie mizerne:
- Brak stabilnego procesu – jeśli sekwencje działań i zasady zmieniają się z tygodnia na tydzień, trudno o sensowne wzorce do nauki dla modeli AI.
- Brak podstawowej standaryzacji pracy – różni operatorzy inaczej raportują to samo zdarzenie, różne zmiany mają różne „sposoby” na ten sam problem.
- Ciągłe „gaszenie pożarów” – jeśli większość dnia to reagowanie na nagłe kryzysy, nie ma przestrzeni na spokojne wdrożenia i iteracje.
W takich przypadkach więcej przyniesie porządkowanie podstaw: ustalenie standardów pracy, poprawienie przepływu informacji, uproszczenie procedur. Dopiero kiedy proces jest względnie powtarzalny, AI potrafi wprowadzić dodatkową warstwę optymalizacji. Tu właśnie często zawodzi popularna rada „zacznij od danych i AI” – bez organizacyjnego kręgosłupa modele stają się kolejną zabawką działu IT, zamiast narzędziem codziennej pracy na hali.
Często powtarzane hasło brzmi: „zacznij mały pilotaż AI i pokaż szybkie zwycięstwo”. To działa tylko wtedy, gdy istnieje choć minimalnie przewidywalne otoczenie procesu, do którego taki pilotaż można „przyszyć”. Jeśli każdy dzień jest inny, a decyzje zależą głównie od doraźnych telefonów i presji klienta, model nie ma czego się uczyć – jutro reguły gry znów będą inne. W takich warunkach szybkie zwycięstwo zwykle kończy się szybkim rozczarowaniem i utratą zaufania do kolejnych inicjatyw technologicznych.
Dużo rozsądniejsze bywa ograniczenie ambicji technologicznych i postawienie prostego celu: przekształcić „chaos sterowany telefonem” w stabilny, choćby średnio zoptymalizowany proces. Czasem oznacza to tak przyziemne działania, jak ujednolicenie formularza raportowania przestojów, wprowadzenie jednej wersji planu produkcji dla wszystkich zmian czy usunięcie kilku „prywatnych” arkuszy planistycznych. Dopiero gdy ludzie widzą, że na tych fundamentach da się pracować bez ciągłego gaszenia pożarów, sensownie jest wprowadzać modele predykcyjne czy rekomendacyjne.
Dobrą praktyką jest otwarte zakomunikowanie, że AI nie jest lekiem na brak organizacji. W jednym z zakładów dopiero jasna decyzja zarządu, że przez kwartał celem numer jeden jest stabilizacja raportowania i standaryzacja przyczyn przestojów, a nie „pilotaż AI do wszystkiego”, pozwoliła uniknąć serii nieudanych wdrożeń. Gdy po tych trzech miesiącach wrócono do tematu AI, zespół projektowy miał konkretne, wiarygodne dane i jasno zdefiniowany obszar, w którym przewidywanie problemów logistycznych miało sens.
Dane jako paliwo: co faktycznie trzeba mierzyć, żeby AI miała sens
Najczęstszy błąd to przekonanie, że „im więcej danych, tym lepiej”. W praktyce przeładowanie systemu przypadkowymi sygnałami skutkuje tym, że modele uczą się szumu, a nie procesu. Zamiast polować na każdy możliwy czujnik, lepiej zacząć od pytania: jaką konkretną decyzję chcemy wesprzeć lub zautomatyzować? Inny zestaw danych będzie potrzebny do przewidywania przestojów, inny do dynamicznego planowania transportu wewnętrznego, a jeszcze inny do oceny ryzyka braków materiałowych.
Przy predykcyjnym utrzymaniu ruchu kluczowe są dane czasowo powiązane z faktycznymi zdarzeniami: stany alarmów, wibracje, temperatury, mikroprzestoje, drobne korekty parametrów przez operatora. Natomiast przy optymalizacji logistyki wewnętrznej większą rolę zagrają informacje o czasie przejazdów, kolejkach pod maszynami, faktycznych oknach załadunkowych, a nie tylko „planowanych ETA z ERP”. Jedno i drugie to „dane produkcyjne”, ale ich przydatność dla danego modelu jest skrajnie różna.
Popularna rada, aby najpierw zbudować „hurtownię danych ze wszystkiego”, często kończy się kilkuletnim projektem integracyjnym bez widocznego efektu na hali. Rozsądniejsza alternatywa to wąski, ale głęboki wycinek danych powiązany z konkretną decyzją, np. stopień wypełnienia bufora przed kluczową maszyną, realne czasy przestojów i faktyczne momenty przyjazdu materiału. Takie podejście wymusza selekcję: co naprawdę ma związek z przestojami, a co jest tylko „miłym dodatkiem do dashboardu”.
Dane w logistyce produkcji nie muszą być idealne, ale powinny być wystarczająco dobre, by odróżnić normalny stan od problemu. Jeżeli system rejestruje przestój raz jako „awaria”, raz jako „brak materiału”, a innym razem wcale, model poradzi sobie gorzej niż doświadczony brygadzista. Natomiast jeśli błędy są powtarzalne i rozumiane (np. wiemy, że jedna zmiana zaniża raportowane czasy o 10–15%), można je częściowo skompensować w analizie i mimo wszystko uzyskać wartość z AI.
Przy wyborze tego „wąskiego, ale głębokiego” wycinka przydaje się proste ćwiczenie: wypisać kluczowe decyzje (np. czy zatrzymać linię na przezbrojenie, czy puścić kolejne zlecenie) i przy każdej dopisać maksymalnie pięć rodzajów danych, które realnie wpływają na wybór. Jeśli coś nie jest w tej piątce, prawdopodobnie nie powinno być priorytetem na starcie projektu AI. Dopiero gdy model zaczyna działać i pokrywać podstawowe przypadki, można dokładać kolejne źródła sygnałów, zamiast topić się w dziesiątkach zmiennych od pierwszego dnia.
Popularna rada „zbierzmy wszystko, a potem zobaczymy, co model znajdzie” rzadko kończy się dobrze w warunkach produkcji. Sprawdza się w laboratoriach R&D, ale nie tam, gdzie każda godzina przestoju ma konkretny koszt. Sensowniejsze bywa podejście odwrotne: najpierw uzgodniona logika biznesowa, potem dane, które ją odzwierciedlają. Przykład: jeśli celem jest redukcja przestojów z braku materiału, to podstawą są czasy dostaw, poziomy buforów i rzeczywiste momenty przyjazdu wózków, a nie pełny zrzut wszystkich tagów z PLC.
Inny, często pomijany aspekt to czytelność danych dla ludzi. Modele można wytrenować na surowych logach maszynowych, ale jeśli planista lub kierownik zmiany nie jest w stanie własnoręcznie odtworzyć kluczowych metryk (np. poziomu obciążenia bufora czy średniego czasu oczekiwania na materiał), rośnie ryzyko odrzucenia rozwiązania. Dane, na których uczymy AI, powinny dać się w prosty sposób „opowiedzieć” operatorom: skąd pochodzą, jak powstają i jak przekładają się na ich codzienne decyzje.
W logistyce produkcji największą przewagę daje nie tyle sama ilość sygnałów, ile spójność opowieści, jaką z tych danych można złożyć. Jeśli wykresy z AI pokazują dokładnie to, co brygadzista intuicyjnie widzi na hali, ale z godzinowym wyprzedzeniem, zaufanie buduje się samo. Jeżeli natomiast model operuje na tajemniczych wskaźnikach, których nikt nie rozumie, nawet świetne algorytmy szybko trafią do szuflady. Ostatecznie to połączenie: sensowny wybór danych, ich adekwatność do decyzji i czytelność dla ludzi, decyduje, czy AI w logistyce produkcji stanie się realnym „obniżaczem przestojów i kosztów”, czy zostanie kolejnym hasłem w strategii na slajdach zarządu.
Kluczowe zastosowania AI w logistyce produkcji – selekcja zamiast katalogu życzeń
Typowa lista „AI w produkcji” obejmuje wszystko: od autonomicznych wózków, przez rozpoznawanie obrazów, po zaawansowane symulacje. W realnym zakładzie taki wachlarz szybko zamienia się w paraliż decyzyjny. Zamiast pytać, co jeszcze można zautomatyzować, lepiej zadać przewrotne pytanie: z czego świadomie rezygnujemy na pierwsze 12–18 miesięcy, żeby dowieźć kilka konkretnych rezultatów.
Przy logistyce produkcji dobrze sprawdza się podział na trzy kategorie zastosowań AI, z których zwykle wybiera się maksymalnie jedno–dwa na start:
- Prognozowanie i wczesne ostrzeganie – modele, które wskazują rosnące ryzyko problemu (przestój, brak materiału, korek w transporcie wewnętrznym).
- Rekomendacje operacyjne – podpowiedzi, co zrobić teraz lub za chwilę (przestawić zlecenie, podnieść priorytet transportu, zbudować bufor).
- Automatyczne sterowanie – AI, która sama podejmuje akcje (kierowanie flotą AGV, dynamiczne przydzielanie zleceń do gniazd).
Popularna rada brzmi: „zacznij od małej automatyzacji, która pokaże moc AI”. W logistyce produkcji to bywa ryzykowne, bo automatyzacja dotyka nerwu zakładu – przepływu materiału. Jeżeli coś pójdzie nie tak, szkody są natychmiastowe. Dużo bezpieczniej jest zaczynać od prognoz i rekomendacji, a dopiero później, na podstawie zaufania i zrozumienia, przechodzić do automatycznego sterowania.
Dojrzały wybór polega na tym, by odrzucić część kuszących zastosowań. Przykład: rozpoznawanie obrazu do kontroli kompletności palet może brzmieć atrakcyjnie, ale jeśli 90% strat kosztowych pochodzi z przestojów kluczowej linii przez brak materiału, to właśnie tam AI ma największą dźwignię. Mniej efektownie wygląda na prezentacji, ale szybciej spłaca się w wynikach.
AI do planowania logistyki wewnętrznej: kiedy „inteligentny harmonogram” naprawdę pomaga
Planowanie przejazdów wózków, zasilania linii i obsługi stref odkładczych to klasyczny kandydat do użycia AI. Jest jednak haczyk: model nie naprawi błędnej polityki planowania. Jeśli priorytety zleceń skaczą w zależności od ostatniego telefonu z handlowego, nawet najlepszy algorytm będzie tylko szybciej liczył chaos.
AI do planowania logistyki wewnętrznej sensownie sprawdza się tam, gdzie spełnione są przynajmniej trzy warunki:
- Jest ustalona hierarchia priorytetów (np. zlecenia „must ship today” są jasno oznaczone i stanowią ograniczoną część wolumenu).
- Istnieje realistyczna mapa zasobów i ograniczeń – znane są czasy przejazdów, dostępność wózków, pojemność buforów, okna czasowe przyjęcia materiałów.
- Zmiany w planie da się odzwierciedlić w systemie szybko i bez „obejść” w Excelu lub na tablicy.
Dopiero w takim środowisku modele optymalizacyjne (często hybryda klasycznych metod OR z komponentami uczenia maszynowego) rzeczywiście pomagają: wyłapują konflikty, proponują drobne korekty tras, sygnalizują przyszłe „wąskie gardła”.
Przeciwwagą dla modnego podejścia „wrzućmy wszystkie ograniczenia do jednego supermodelu” jest strategia lokalnych usprawnień. Zamiast od razu optymalizować cały ruch w zakładzie, można skupić się na jednym newralgicznym korytarzu lub gnieździe maszyn, gdzie korek materiałowy pojawia się niemal codziennie. Model, który przewidzi narastający korek 30–40 minut wcześniej i zasugeruje prostą zmianę (np. przesunięcie dwóch zleceń albo priorytetu wózka), bywa praktyczniejszy niż imponujący, ale kruchy system „totalnej optymalizacji”.
Kontrola buforów i poziomów zapasów w toku z użyciem AI
Druga grupa zastosowań, która wprost przekłada się na mniejsze przestoje i niższe koszty, to inteligentne zarządzanie buforami. Popularna rada: „zwiększmy zapasy bezpieczeństwa, żeby uniknąć braków”, działa do czasu, aż koszty zamrożonego kapitału i braku miejsca fizycznego zaczną przewyższać zyski. AI pozwala podejść do buforów bardziej elastycznie.
Modele mogą, na podstawie historii przepływu, zmienności dostaw wewnętrznych i zewnętrznych oraz aktualnego obciążenia linii, proponować dynamikę poziomów minimalnych. Zamiast stałego „min–max”, bufor przed krytyczną maszyną może mieć wyższy poziom bezpieczeństwa w okresach wzmożonej zmienności (np. przy dużej liczbie krótkich serii), a niższy przy spokojnym, powtarzalnym miksie produkcji.
Kiedy takie podejście nie zadziała? Gdy fizyczna pojemność strefy buforowej jest już na granicy, a przepływ materiału blokują głównie błędy organizacyjne – np. brak etykiet, mylenie numerów partii, ręczne przestawianie palet „na chwilę”. W takim środowisku AI będzie raczej rejestrować skutki bałaganu niż go redukować. Dopiero po uporządkowaniu podstaw (oznaczenia, standardy lokalizacji, prosty system rezerwacji miejsca) model ma szansę sensownie sterować poziomami zapasów w toku.
Praktyczna alternatywa do „AI od razu do wszystkich buforów” to pilotaż na jednym krytycznym buforze, którego opróżnienie najczęściej zatrzymuje linię. Model może uczyć się zależności między: tempem zasilania, tempem poboru, planem zleceń i rzeczywistymi przestojami. Po kilku tygodniach zwykle widać pierwsze wzorce, których nie wychwycił żaden raport – np. że ryzyko pustego bufora rośnie nie tylko przy dużej liczbie zleceń, ale także przy specyficznym ich układzie (seria po serii o podobnym profilu zużycia komponentów).
Wspomaganie decyzji planistów: od prognoz do zaufanych rekomendacji
Często pomijanym obszarem jest wsparcie samego planisty logistyki i produkcji. Popularna rada mówi: „dajmy im lepszy dashboard, resztę zrobią sami”. Problem w tym, że przy setkach zleceń i setkach zmiennych dodatkowa wizualizacja nie dodaje mocy przerobowej mózgu. AI może pełnić rolę „drugiego planisty” – nie po to, by zastąpić człowieka, ale by proponować warianty, których ręcznie nikt by nie policzył.
Sensowny początek to proste, ale uczciwe funkcje:
- Ocena wykonalności planu – model wskazuje zlecenia, które z dużym prawdopodobieństwem „wypadną” z grafiku, bo wymagają więcej czasu transportu, przezbrojeń czy ręcznych inspekcji niż założono.
- Symulacja „co-jeśli” – szybkie przeliczenie skutków przesunięcia kilku kluczowych zleceń, zmiany priorytetu czy czasowego ograniczenia dostępności wózków.
- Wczesne ostrzeganie o konfliktach – sygnalizacja, że za trzy godziny dwie linie będą walczyć o ten sam zasób logistyczny.
Popularna rada „zaufaj algorytmowi, on wie lepiej” zwykle kończy się oporem. Planista, który odpowiada twarzą przed produkcją i klientem, musi rozumieć logikę rekomendacji. Dlatego na tym etapie lepiej sprawdza się AI z wyjaśnieniami: zamiast czarnej skrzynki, która mówi „przestaw to zlecenie”, system pokazuje, jakie przesłanki prowadzą do takiej sugestii (np. przewidywany korek materiałowy, wzrost ryzyka przestoju, wykorzystanie wózków powyżej założonego progu).
W jednym z zakładów dopiero dodanie prostego „uzasadnienia” do każdej rekomendacji – dwóch–trzech kluczowych czynników z wagami – sprawiło, że planista zaczął faktycznie korzystać z podpowiedzi. Przez pierwsze tygodnie częściej je odrzucał niż akceptował, ale po porównaniu kilku scenariuszy w czasie rzeczywistym sam poprosił o rozszerzenie zakresu rekomendacji.
Predykcyjne utrzymanie ruchu: mniej przestojów dzięki lepszym decyzjom logistycznym
Predykcyjne utrzymanie ruchu kojarzy się głównie z maszynami – czujnikami wibracji, analizą oleju czy monitorowaniem temperatur. W logistyce produkcji istotniejsze bywa to, jak informacje o stanie technicznym maszyn są wplecione w planowanie przepływu materiału. Samo przewidzenie awarii to dopiero połowa wartości; druga połowa to decyzje logistyczne, które redukują skutki tej awarii.
Kiedy predykcja awarii nie obniży przestojów
Istnieją sytuacje, w których inwestycja w zaawansowane modele predykcyjne nie da oczekiwanej poprawy:
- Brak elastyczności w planie – jeśli zleceń nie da się realnie przeplanować na inne maszyny lub zmiany, bo każdy klient „musi być na czas”, predykcja ogranicza się do wcześniejszego powiadomienia o nieuchronnym przestoju.
- Brak zapasu zdolności produkcyjnych – gdy wszystkie kluczowe linie chodzą nieustannie „na 100%”, a nie ma alternatywnych ścieżek, trudno „uciec” z produkcją przed planowanym zatrzymaniem.
- Chaotyczne okna serwisowe – jeśli planowane przeglądy i remonty są oderwane od realnej sytuacji logistycznej, informacje z AI lądują w szufladzie.
W takich warunkach bardziej sensowne jest najpierw zbudowanie minimum elastyczności: zdefiniowanie alternatywnych ścieżek procesu, utworzenie prostych „scenariuszy awaryjnych” dla kilku kluczowych maszyn, ustalenie zasad buforowania zleceń przed planowanymi przestojami. Dopiero wtedy model predykcyjny ma pole do działania – jego wskazówki można przełożyć na konkretne ruchy logistyczne, a nie tylko na bardziej precyzyjne raporty o awarii.
Łączenie sygnałów technicznych z danymi logistycznymi
Największą dźwignię daje połączenie danych z utrzymania ruchu z realnym przepływem materiału. Zamiast osobnych systemów – jednego do predykcji awarii, drugiego do planowania logistyki – warto zbudować wspólną oś czasu, na której widać:
- rosnące prawdopodobieństwo awarii lub konieczności interwencji serwisowej,
- aktualny stan buforów przed i za maszyną,
- planowane i rzeczywiste dostawy materiałów,
- obciążenie sąsiednich gniazd produkcyjnych.
Na tej bazie modele mogą nie tylko wskazywać: „maszyna X z 80% prawdopodobieństwem wymaga zatrzymania w ciągu najbliższych 12 godzin”, ale też proponować scenariusze logistyczne:
- przyspieszenie części zleceń, by „przepchnąć” priorytetowe partie przed wymianą krytycznego elementu,
- przekierowanie materiału na alternatywną linię, jeśli przewidywany czas postoju przekracza określony próg,
- celowe zbudowanie większego bufora za maszyną, by podtrzymać pracę kolejnego gniazda w trakcie planowanego postoju.
W jednym z zakładów produkcji komponentów metalowych dopiero powiązanie alarmów z systemu CMMS z danymi o buforach ujawniło, że część „nagłych” przestojów logistycznych była w praktyce skutkiem przewidywalnych, ale źle skoordynowanych interwencji serwisowych. Sam model predykcyjny był sprawny, ale nie istniał mechanizm, który przekładałby jego wskazania na ruch planu i logistyki.
Priorytetyzacja zleceń serwisowych z pomocą AI
Utrzymanie ruchu najczęściej dysponuje listą zgłoszeń, które „trzeba zrobić”. Klasyczna priorytetyzacja opiera się na typie maszyny, rodzaju zgłoszenia i doświadczeniu służb UR. AI może tu wprowadzić dodatkowy wymiar: logistyczny wpływ opóźnienia interwencji.
Model, który łączy historię awarii, aktualny plan produkcji i poziomy buforów, potrafi oszacować, które zgłoszenie realnie zwiększa ryzyko przestoju całej linii lub niedostarczenia kluczowego zlecenia na czas. W efekcie dwa identyczne technicznie zgłoszenia mogą mieć różny priorytet, bo jedno dotyczy maszyny z krytyczną rolą w łańcuchu dostaw, a drugie – stanowiska, które pół dnia może „dogonić” zaległości.
Popularna rada: „priorytetuj po krytyczności maszyny”, jest zbyt uproszczona. Maszyna teoretycznie krytyczna może być w danym tygodniu obciążona w 50%, a inna, formalnie mniej ważna, pracować non stop pod pilne zlecenia. AI umożliwia dynamiczne podejście: priorytet wynika nie tylko z klasy sprzętu, ale także z jego bieżącego znaczenia logistycznego.
Okna serwisowe zsynchronizowane z przepływem materiału
Klasycznym problemem jest „planowane okno serwisowe”, które w praktyce pojawia się w najgorszym możliwym momencie: gdy linia jest obciążona, a bufor pusty. Z drugiej strony ciągłe przesuwanie przeglądów „aż się uspokoi” kończy się awarią w środku krytycznego zlecenia. AI daje możliwość szukania realnych, a nie życzeniowych okien serwisowych.
Modele mogą szukać takich przedziałów czasowych, w których koszt zatrzymania jest naprawdę najmniejszy, biorąc pod uwagę nie tylko kalendarz produkcji, ale też:
- przewidywane czasy dojazdu materiału od kluczowych dostawców,
- prognozowane „dołki” obciążenia sąsiednich gniazd,
- okna dostępności ekip serwisowych i części zamiennych.
Zamiast schematu „co drugi piątek po południu serwis”, pojawia się dynamiczny harmonogram, który raz wskaże okno w środku tygodnia, a innym razem przesunie przegląd o kilkanaście godzin, bo akurat wtedy linia i tak będzie czekała na dostawę blach, komponentów czy półproduktów. Warunek jest jeden: logistyka, produkcja i UR muszą korzystać z tej samej, spójnej wersji planu, a nie z trzech różnych arkuszy Excela.
Popularna rada „serwisuj w dołkach produkcyjnych” brzmi dobrze, dopóki dołki faktycznie istnieją i da się je przewidzieć. W zakładach pracujących ciągle na wysokim obciążeniu AI częściej szuka lokalnych minimum strat, a nie idealnych „dziur” – krótkich interwałów, w których połączenie mniejszego obciążenia, lepszych buforów i dostępności części sprawia, że przerwa najmniej uderza w cały łańcuch.
W jednym przedsiębiorstwie przestawiono podejście z „serwis raz na X godzin pracy” na model, który łączył rzeczywiste zużycie komponentów, stan buforów i obciążenie wysyłek. Okazało się, że kilka przeglądów da się wykonać wcześniej, „przy okazji” postoju logistycznego, zamiast zatrzymywać linię osobno tydzień później. Zmiana nie wymagała cudów technologicznych – kluczowe było wspólne spojrzenie na plan i akceptacja, że idealnie równy interwał serwisowy jest mniej ważny niż mniejsza liczba gwałtownych przestojów.
AI w logistyce produkcji nie jest magicznym modułem „do optymalizacji”, który wystarczy podłączyć do istniejącego chaosu. Największą przewagę przynosi tam, gdzie procesy są już wystarczająco uporządkowane, by dało się z nich wyłuskać sygnał, ale wciąż zbyt złożone, by człowiek był w stanie ręcznie rozważyć wszystkie scenariusze. Im lepiej zdefiniowane ścieżki przepływu materiału, reguły buforowania i zasady współpracy z utrzymaniem ruchu, tym większy sens ma dokładanie kolejnych warstw predykcji i automatyzacji. Dzięki temu algorytmy nie zastępują ludzi „na froncie”, tylko odciążają ich z liczenia wariantów, zostawiając im to, czego nie da się łatwo skwantyfikować: świadomą decyzję, które ryzyko jest w danej chwili akceptowalne.
Automatyzacja decyzji logistycznych: kiedy oddać stery algorytmom, a kiedy trzymać ręcznie
Przy rosnącej złożoności przepływów naturalna jest pokusa, by „oddać decyzje AI”. Kuszący scenariusz: system sam przeplanuje zlecenia, przekieruje materiał, zmieni priorytety wysyłek. Problem zaczyna się wtedy, gdy algorytm działa w świecie, w którym większość reguł istnieje tylko w głowach ludzi, a nie w danych.
Popularne hasło: „pozwól AI podejmować decyzje operacyjne” brzmi dobrze, ale kompletnie nie działa tam, gdzie brakuje trzech elementów:
- jawnych reguł i ograniczeń (np. które zlecenia są naprawdę „nietykalne”),
- spójnej struktury danych (te same indeksy, te same kalendarze w całym łańcuchu),
- mechanizmu cofnięcia decyzji – jasnego „undo”, gdy algorytm jednak poszedł w złą stronę.
Bez tego automatyzacja nie obniża przestojów, tylko przyspiesza generowanie złych decyzji. Zamiast „AI jako autopilot” skuteczniejsze jest podejście stopniowe: najpierw rekomendacje z pełnym kontekstem, dopiero później automatyczne wykonanie wybranych klas decyzji.
Rekomendacja zamiast rozkazu: półautomatyczne sterowanie przepływem
Dobrą praktyką jest wydzielenie decyzji na trzy poziomy:
- tylko informacja – system sygnalizuje ryzyko (np. przewidywany brak materiału za 6 godzin), ale nie proponuje działań,
- rekomendacja – algorytm wskazuje 2–3 warianty z oceną skutków (np. wydłużenie zmiany, przekierowanie partii, budowa bufora),
- auto-wykonanie – system sam zatwierdza konkretne zmiany, w wąsko zdefiniowanych przypadkach i w jasno opisanych granicach.
Przejście z informowania do auto-wykonania powinno następować po udokumentowaniu, że rekomendacje w danym typie sytuacji były przez ludzi akceptowane i dawały oczekiwany efekt. Innymi słowy: algorytm musi „udowodnić”, że jego logika jest zgodna z praktyką zakładu, zanim dostanie prawo do działania bez klikania planisty.
W jednym z zakładów automotive przez pierwsze miesiące system AI jedynie proponował przeplanowania wysyłek wewnętrznych między magazynami. Dopiero gdy okazało się, że planista w 90% przypadków wybierał opcję oznaczoną przez model jako „najmniej strat”, włączono auto-akceptację w najprostszych przypadkach – np. drobne przesunięcia transportów w ramach tej samej zmiany.
Gdzie automatyzować w pierwszej kolejności
Zamiast marzyć o „w pełni autonomicznej logistyce”, rozsądniej zacząć od fragmentów, gdzie:
- reguły są stabilne i dobrze zrozumiane (np. uzupełnianie standardowych komponentów, ruchy palet między buforami),
- skutki błędu są odwracalne i tanie (łatwo „odkręcić” złą decyzję bez naruszania serwisu klienta),
- częstotliwość decyzji jest zbyt wysoka dla ludzi, ale niski jest ich „strategiczny ciężar” (np. przydział zadań dla wózków AGV).
Paradoksalnie tam, gdzie presja jest największa – krytyczne zmiany, kluczowe zlecenia, duże przezbrojenia – pełna automatyzacja powinna przyjść najpóźniej. W tych obszarach AI ma najpierw dostarczać analizy wariantowe i „konsekwencjowniki” (jakie skutki w planie pociągnie dana decyzja), a nie zamieniać planistów w widzów.
AI a zarządzanie buforami: mniej magicznych formuł, więcej kontekstu
Bufory materiałowe są jednym z głównych narzędzi walki z przestojami, ale też jednym z głównych źródeł mrożonego kapitału. Popularna rada: „policz optymalny zapas bezpieczeństwa” rzadko działa w produkcji z dużą zmiennością. Jedno „optymalne” ustawienie nie przetrwa nawet kilku tygodni zmian miksu, awarii i opóźnień dostaw.
Dynamiczne bufory zamiast stałych poziomów minimalnych
Modele AI mogą patrzeć na bufory jak na zmienną decyzję, a nie stały parametr. Zamiast utrzymywać jeden „święty” poziom minimalny, proponują:
- czasowe podniesienie zapasu przed newralgicznym tygodniem (np. duży projekt klienta, przewidywane przestoje serwisowe u dostawcy),
- świadome obniżenie bufora tam, gdzie logistyka ma realne obejście (np. lokalny dostawca o krótkim lead time),
- różne poziomy dla dni roboczych i weekendów, zależnie od dostępności transportu wewnętrznego.
Warunkiem sensownych rekomendacji jest połączenie kilku typów danych: historii zużycia materiałów, wiarygodności dostawców, planów UR, harmonogramów wysyłek. Jeśli system widzi tylko jedno z tych źródeł (np. średnie zużycie z ERP), produkuje eleganckie liczby, które w praktyce nie bronią się przy pierwszym poważniejszym zaburzeniu łańcucha.
Gdzie nie ma sensu „wyciskać” buforów
Presja finansowa sprzyja pomysłom, by „zoptymalizować zapasy wszędzie”. W logistyce produkcji bardziej opłaca się podzielić pozycje na trzy koszyki:
- krytyczne dla ciągłości linii – tu celem jest przede wszystkim odporność, a nie minimalizacja stanów,
- łatwo dostępne (krótki lead time, wielu dostawców) – tu można agresywnie korygować bufor, wspierając się prognozami AI,
- trudne logistycznie (długi transport, odprawy, szczególne warunki składowania) – tu algorytm raczej szuka scenariuszy awaryjnych niż „idealnego” poziomu zapasu.
AI w obszarze buforów ma największy sens w środkowej grupie – tam, gdzie decyzje są częste, ryzyko umiarkowane, a dostępne są dane o dostawach i zużyciu. Próba „dokręcania śruby” na buforach krytycznych często prowadzi do pozornego sukcesu na wskaźnikach zapasu, a realnego wzrostu przestojów linii po kilku miesiącach.
Wizualizacja i wyjaśnialność: dlaczego planista musi „widzieć”, co robi algorytm
Nawet najlepszy model predykcyjny stanie się wrogiem zespołu, jeśli jego decyzje będą wyglądały jak magia. W logistyce produkcji, gdzie każdy błąd w planie jest natychmiast widoczny na hali, zaufanie do systemu jest równie ważne jak sama dokładność prognoz.
Od „czarnej skrzynki” do wspólnego pulpitu
Zamiast ukrywać logikę AI, praktyczniejsze jest pokazanie jej efektów w postaci wspólnego pulpitu decyzyjnego, na którym każdy widzi:
- jakie zdarzenie lub prognoza wywołała rekomendację (np. rosnące opóźnienie dostawcy, spadający poziom bufora, sygnał z CMMS),
- jakie warianty zostały przeanalizowane (i jakie były ich przewidywane skutki w godzinach przestojów, OTIF, OEE),
- dlaczego algorytm wskazał konkretną opcję jako preferowaną.
Nie chodzi o zdradzanie szczegółów matematycznych, tylko o pokazanie przyczynowo-skutkowego łańcucha decyzji. Planista, który widzi, że system „wybrał scenariusz B, bo przy A zabrakłoby bufora na linii numer 3”, dużo chętniej zaufa kolejnym rekomendacjom – albo przynajmniej będzie wiedział, z czym polemizuje.
Używanie AI do nauki zespołu, a nie zamiast zespołu
Jednym z ciekawszych zastosowań jest wykorzystanie systemu nie tylko w trybie „online”, lecz także w trybie symulacji. Zespół planistów i logistyki może odtwarzać historyczne sytuacje z nowymi modelami AI, sprawdzając:
- jakie decyzje system by wtedy zaproponował,
- które przestoje można było złagodzić, gdyby algorytm był wtedy wdrożony,
- jak zmiana lokalnych reguł (np. maksymalnego obciążenia linii) wpłynęłaby na liczbę koniecznych interwencji.
Taki „trening na nagraniu” działa w obie strony. Zespół uczy się patrzeć szerzej na skutki swoich decyzji, a jednocześnie pokazuje twórcom modeli, gdzie logika algorytmu rozmija się z realnymi ograniczeniami hali – tymi, które rzadko są gdziekolwiek zapisane, a które potrafią zrujnować nawet najpiękniejszy plan.
Integracja z istniejącą infrastrukturą: mniej rewolucji, więcej mostów
Większość zakładów nie startuje z „czystą kartą”. Funkcjonują równolegle systemy ERP, MES, WMS, CMMS, dziesiątki raportów Excel i nieformalnych notatek. Ambicją wielu projektów AI jest „zastąpić to wszystko jednym spójnym narzędziem”. W praktyce kończy się to latami wdrożeń i niewielkim wpływem na przestoje.
AI jako nakładka, nie jako „nowy mózg”
Bardziej skuteczne podejście traktuje AI jako nakładkę koordynującą niż jako centralny system, który ma zastąpić całą resztę. Kluczowe jest zbudowanie prostych mostów:
- zaciąganie kluczowych danych z istniejących systemów w cyklach dopasowanych do ich możliwości (nie każdy MES jest gotowy na „prawie online”),
- oddawanie wyników nie tylko w jednym nowym interfejsie, ale też tam, gdzie ludzie już pracują – np. komentarze w zleceniu ERP, alerty w systemie CMMS, sygnały dla terminali na hali,
- stopniowe poszerzanie zakresu integracji, gdy pierwszy, węższy przypadek użycia przyniesie mierzalny efekt.
W jednej fabryce komponentów AGD pierwszym krokiem integracji nie było pełne spięcie AI z ERP, lecz prosty eksport danych o zleceniach i statusach buforów do osobnego modułu analitycznego. Rekomendacje wracały z powrotem w formie prostych list „zleceń do przyspieszenia” i „buforów krytycznych”, które planista ręcznie odtwarzał w planie. Dopiero po kilkunastu tygodniach zdecydowano, które z tych kroków zautomatyzować.
Ostrożnie z „real time”: kiedy wystarczy „near real time”
Ambicja posiadania wszystkiego „w czasie rzeczywistym” bywa drogim luksusem. W logistyce produkcji duża część sensownych decyzji logistycznych może być spokojnie podejmowana w rytmie:
- aktualizacja co 5–15 minut – dla przepływów na hali,
- raz na godzinę – dla planowania transportu wewnętrznego,
- raz dziennie – dla korekt strategii buforów czy okien serwisowych.
Próba spięcia wszystkiego w absolutny realtime często kończy się przeciążonymi integracjami, setkami nieistotnych alertów i sfrustrowanym zespołem. Zanim padnie decyzja o „online”, warto ustalić czas reakcji człowieka w danym procesie – jeśli planista i tak koryguje plan co godzinę, aktualizacja danych co sekundę jest sztuką dla sztuki.
Kultura decyzji opartych na danych: bez tego AI zostanie drogim gadżetem
Nawet najlepiej wkomponowane modele nie obniżą przestojów i kosztów, jeśli organizacja nadal podejmuje decyzje głównie „na czuja” lub według hierarchicznej tradycji. Największą zmianą nie jest sama technologia, lecz przesunięcie ciężaru z „kto ma silniejszą opinię” na „który scenariusz ma lepsze dane i symulacje za sobą”.
Od winnych do przyczyn: jak AI zmienia narrację o przestojach
Typowa reakcja na przestój to szukanie winnych: dostawca, operator, utrzymanie ruchu, planista. Dane z systemów AI pozwalają prowadzić inną rozmowę: co było łańcuchem zdarzeń, który doprowadził do zatrzymania, i które z tych ogniw jesteśmy w stanie realnie kontrolować.
Jeżeli logistyka widzi, że algorytm już 6 godzin wcześniej sygnalizował narastające ryzyko braku materiału, ale rekomendacje zostały zignorowane, dyskusja nie kręci się wokół „kto zawinił”, tylko wokół tego, dlaczego system nie był traktowany jako źródło informacji pierwszego rzędu. Taka zmiana narracji stopniowo zwiększa skłonność do korzystania z modeli – nie dlatego, że „tak każe centrala”, lecz dlatego, że kolejny raz nie chce się przechodzić przez ten sam rodzaj przestoju.
Progi zaufania i „prawo do niezgody”
Zdrowy ekosystem decyzyjny z AI ma w sobie wbudowane prawo do świadomej niezgody. Planista może odrzucić rekomendację, ale musi wskazać powód (np. „brak ludzi na dodatkową zmianę”, „planowany audyt klienta na tej linii”). Taka adnotacja jest później paliwem do uczenia modeli i korekty reguł.
Równocześnie warto ustalać progi zaufania – sytuacje, w których domyślnie stosuje się rekomendację systemu, oraz takie, w których zawsze wymagana jest dodatkowa akceptacja. Inne zasady mogą obowiązywać dla korekty tras wózków AGV, a inne dla realokacji zlecenia do innego kraju czy zakładu.
Paradoksalnie, zbyt agresywne „oddanie sterów” algorytmowi potrafi zniszczyć zaufanie szybciej niż jego brak. Gdy system zbyt często forsuje zmiany planu, a lokalne ograniczenia nie są jeszcze dobrze odwzorowane w modelach, ludzie zaczynają go omijać i wracać do Excela. Lepsza jest faza, w której AI ma formalnie status doradcy z prawem głosu, a nie nieomylnego sędziego – szczególnie w środowiskach z dużą liczbą wyjątków i pracy ręcznej.
Dobrym wyznacznikiem dojrzałości jest moment, w którym zespół sam domaga się większej automatyzacji konkretnych decyzji, bo widzi, że: po pierwsze, modele są stabilne, po drugie, ręczne ingerencje różnią się między planistami, a po trzecie, każda taka „indywidualna modyfikacja” zwiększa ryzyko przestoju. Zamiast odgórnego nakazu pełnej automatyzacji, lepiej pozwolić, by część zakresu „kliknę – zaakceptuj” naturalnie przeszła w tryb „zatwierdza się samo, chyba że ktoś świadomie przerwie proces”.
Innym sygnałem zdrowej kultury jest to, że odrzucenie rekomendacji nie kończy rozmowy, tylko ją zaczyna. Jeśli planista trzy razy pod rząd ignoruje sugestie korekty buforów na konkretnej linii, to raczej znak, że w procesie kryje się dodatkowe ograniczenie (np. nietypowe przezbrojenia, sezonowość kontroli jakości), którego nie ma jeszcze w danych. W dojrzałych organizacjach takie rozjazdy są impulsem do poprawy modeli, a nie pretekstem do dyscyplinowania ludzi.
Najbardziej odporne na przestoje fabryki łączy kilka prostych cech: mają wystarczająco dobre dane (nie idealne), główne decyzje logistyczne są oparte na powtarzalnych regułach wspieranych przez AI, a jednocześnie ludzie zachowują prawo do świadomego „nie” – z obowiązkiem wyjaśnienia kontekstu. To właśnie z tego dialogu między algorytmem a praktyką rodzą się systemy, które realnie zmniejszają liczbę niespodziewanych zatrzymań, zamiast być kolejną „innowacją”, która kończy w szufladzie po pierwszym większym kryzysie na hali.
Od pilota do skalowania: jak nie zabić efektu pierwszych sukcesów
Największe korzyści z AI w logistyce produkcji nie wynikają z jednego „magicznego” projektu, tylko z konsekwentnego rozszerzania zakresu. Dokładnie tu najłatwiej popełnić błąd – po udanym pilocie organizacja próbuje od razu objąć całą fabrykę, a czasem całą grupę zakładów, tym samym podejściem. Efekt: przeciążone zespoły, rozmyte cele i powrót do starych nawyków.
„Zróbmy roll-out do wszystkich zakładów” – kiedy to jest zła rada
Klasyczny scenariusz: pierwszy zakład pokazuje spadek przestojów, centrala decyduje o szybkim roll-oucie. Problem w tym, że logistyka produkcji jest silnie lokalna. Teoretycznie podobne linie i produkty, w praktyce:
- inne zwyczaje pracy zmianowej,
- inna jakość i kompletność danych (zwłaszcza w utrzymaniu ruchu),
- inne „niepisane zasady” dotyczące priorytetów klientów czy kampanii produkcyjnych.
Ten sam model, który w jednym zakładzie trafia w punkt, w drugim daje „dziwne” rekomendacje. Ludzie szybko zaczynają je omijać, a projekt AI dostaje łatkę „teorii z centrali, która nie zna realiów”.
Skuteczniejsza droga to skalowanie wzorca, nie konkretnego rozwiązania. Zamiast kopiować gotowy model, lepiej przenieść:
- zestaw kluczowych pytań decyzyjnych (które przestoje chcemy zmniejszyć i jak je mierzymy),
- schemat integracji (jakie dane, z jaką częstotliwością i z jakim minimalnym zakresem jakości),
- mechanizm pracy z zespołem (kto jest „właścicielem” decyzji, jak dokumentuje się odrzucenia rekomendacji).
Modele mogą się różnić między zakładami, natomiast sposób rozmowy o decyzjach i rola AI w procesie pozostają spójne. Dzięki temu organizacja nie dusi się jednym „centralnym” rozwiązaniem, tylko buduje rodzinę dopasowanych zastosowań, które da się porównywać na wspólnych wskaźnikach.
„Najpierw dopracujmy dane, potem AI” – kiedy perfekcjonizm szkodzi
Popularna rada: „Zanim zaczniemy z AI, musimy posprzątać dane”. Brzmi rozsądnie, a jednak w logistyce produkcji rzadko działa w pełnej wersji. Procesy są dynamiczne, zmieniają się linie, rotuje kadra, powstają nowe rodzaje przestojów. Projekt „najpierw zróbmy porządek w danych” potrafi trwać latami i nigdy się nie kończyć.
Praktyczniejsza alternatywa to „porządek na tyle, na ile potrzebuje konkretny przypadek użycia”. Jeśli celem jest redukcja przestojów z braku materiału, to kluczowe stają się:
- czas i przyczyna zatrzymania linii,
- stan buforów i przepływy materiałowe,
- czas reakcji służb logistyki i utrzymania ruchu.
Pozostałe dane (np. szczegółowa struktura kosztów energii czy mikrozatrzymania jakościowe) mogą pozostać w „takim sobie” stanie, dopóki nie są potrzebne do kolejnego etapu. AI jest tu narzędziem, które ujawnia najbardziej opłacalne luki w danych: gdy system nie potrafi dobrze wyjaśnić konkretnej klasy przestojów, wskazuje, gdzie inwestycja w lepsze rejestrowanie informacji przyniesie największy zwrot.
„Najpierw pokaż ROI” – jak nie zabić projektu w zarodku
Żądanie pełnego business case’u jeszcze przed startem jest zrozumiałe. Kłopot w tym, że w złożonych systemach logistycznych uczciwe ROI często wychodzi dopiero po serii krótkich iteracji. Zbyt sztywne oczekiwanie „twardego ROI w 6 miesięcy” prowadzi do wyboru powierzchownych, łatwych do policzenia zastosowań, które niekoniecznie najmocniej zmniejszają przestoje.
Praktyczny kompromis to dwupoziomowe podejście do efektów:
- Poziom 1: wskaźniki pośrednie – jakość prognoz, odsetek trafnych alertów, czas od sygnału do reakcji.
- Poziom 2: wskaźniki biznesowe – redukcja godzin przestojów, mniej akcji „firefighting”, stabilniejsza realizacja terminów.
Na początku mierzy się głównie poziom 1. Dopiero gdy widać, że modele faktycznie „łapią” dynamikę hali i logistyki, można w wiarygodny sposób przypisać im wpływ na poziom 2. To mniej spektakularne niż slajd z ROI zbudowany z założeń, ale znacznie trudniej to potem zakwestionować.
Kiedy AI nie jest najlepszym narzędziem – i co zamiast
W dyskusjach o „fabrykach 4.0” AI bywa przedstawiana jako odpowiedź na wszystko. Tymczasem są obszary logistyki produkcji, gdzie proste reguły i przejrzyste tablice zrobią lepszą robotę niż wyrafinowane modele. Świadome odróżnienie tych dwóch światów oszczędza zarówno budżet, jak i cierpliwość zespołu.
Stabilne, powtarzalne procesy – terytorium reguł, nie modeli
Jeśli dany fragment strumienia wartości ma od lat niemal identyczne obciążenie, stały mix produktów i niewielką liczbę wyjątków, to pierwszym narzędziem nie musi być uczenie maszynowe. Przykład: linia pakowania jednego asortymentu, z prostą strukturą zleceń i minimalną liczbą zmian formatowych.
W takim środowisku lepszy efekt daje:
- doprecyzowanie buforów minimalnych i maksymalnych na wejściu i wyjściu z linii,
- kilka prostych reguł priorytetyzacji w systemie WMS/MES,
- jasne zasady przekazywania informacji między zmianami oraz między logistyką a utrzymaniem ruchu.
AI może się tu pojawić później – jako narzędzie do okresowej weryfikacji, czy reguły nadal są optymalne. Nie musi jednak działać w czasie rzeczywistym ani „wtrącać się” do codziennych decyzji, skoro system już jest stabilny.
Mało danych, dużo wyjątków – najpierw proces, potem algorytmy
Na drugim biegunie są obszary, w których każdy tydzień wygląda inaczej: prototypy, krótkie serie, częste zmiany specyfikacji klienta. Pokusa jest duża: „Użyjmy AI, żeby to opanować”. Problem w tym, że przy niewielkiej liczbie powtarzalnych przypadków modele nie mają się na czym nauczyć.
W takich sytuacjach lepiej zacząć od:
- odchudzenia i uproszczenia ścieżek decyzyjnych (kto faktycznie zatwierdza zmiany),
- standardowych „szablonów” przepływu materiału dla typowych wariantów projektu,
- lepszego rejestrowania przyczyn odstępstw (krótka klasyfikacja zamiast swobodnych opisów).
Dopiero gdy zbierze się portfel kilkudziesięciu, kilkuset powtarzalnych decyzji, AI zaczyna mieć sens – na przykład do podpowiadania najbardziej prawdopodobnego szablonu dla nowego zlecenia albo do wstępnej oceny ryzyka przestojów na etapie ofertowania.
Gdy problem jest strukturalny, a nie „informacyjny”
Część przestojów wynika z faktu, że system fizyczny jest źle zaprojektowany: zbyt długie ścieżki transportu, wąskie gardła na bramkach, wspólna infrastruktura dla zbyt wielu krytycznych linii. W takich przypadkach AI może co najwyżej zoptymalizować nieoptymalne – trochę jak zaawansowany GPS, który próbuje rozładować korek na za ciasnym rondzie.
Jeśli analizy ciągle pokazują te same punkty zapalne, a mimo poprawy planowania nadal dochodzi do zatorów, sygnał jest prosty: zamiast kolejnej warstwy algorytmów potrzebny jest projekt fizycznej przebudowy logistyki wewnętrznej. AI nadal ma tu rolę – pomaga policzyć scenariusze i skutki różnych wariantów layoutu – ale nie rozwiąże problemu bez zmiany „hardwaru” zakładu.
AI jako element projektowania nowych linii i fabryk
Większość dyskusji o AI w logistyce produkcji skupia się na istniejących zakładach. Tymczasem największe oszczędności i najniższe ryzyko przestojów pojawiają się tam, gdzie algorytmy są włączone już na etapie projektowania nowych linii lub całych fabryk.
Od layoutu „na czuja” do layoutu testowanego na symulacjach
Tradycyjny layout hali często powstaje na podstawie doświadczenia kilku osób: technologów, logistyki, utrzymania ruchu. To doświadczenie jest bezcenne, ale ma jedną wadę – trudno ogarnąć mentalnie wszystkie kombinacje obciążeń, awarii, zmian miksu produkcji.
Modele symulacyjne i AI mogą tu działać jako wirtualne laboratorium dla logistyki:
- testowanie różnych wariantów lokalizacji buforów i magazynów przyprodukcyjnych,
- dobór liczby i tras wózków czy AGV pod różne scenariusze popytu,
- symulacja skutków awarii krytycznych maszyn dla przepływu materiału.
Zamiast jednego „docelowego” layoutu powstaje kilka, kilkanaście wariantów, które są oceniane nie tylko pod kątem kosztu inwestycji, lecz także odporności na przestoje. Różnica przychodzi później – w codziennym życiu hali – kiedy okazuje się, że „rzadkie” scenariusze jednak się zdarzają, a fabryka została na nie przygotowana.
Projektowanie buforów i strategii serwisowych razem z logistyką
Typowy błąd w nowych inwestycjach to późne dołączenie logistyki i utrzymania ruchu do projektowania. Najpierw powstaje layout linii, potem „upychane” są miejsca na bufory, regały, trasy transportu i stanowiska serwisowe. Skutek: od początku wbudowane ryzyko przestojów, którego nie da się łatwo skompensować planistyką.
AI pozwala zintegrować te decyzje dużo wcześniej. Przy projektowaniu nowej linii można równolegle modelować:
- profil obciążenia maszyn,
- wymagany poziom buforów w różnych punktach procesu,
- okna serwisowe i przewidywaną awaryjność urządzeń.
Algorytmy nie tylko podpowiadają optymalny rozkład zapasów, lecz także pomagają ustalić, gdzie każde dodatkowe euro zainwestowane w bufor czy dostępność serwisową najbardziej obniża ryzyko przestoju. W efekcie nowa linia startuje z mniejszą liczbą „chorób wieku dziecięcego”, a zespół nie musi przez pierwsze miesiące gasić pożarów, których można było uniknąć przy projektowaniu.
Utrzymanie modeli: AI też potrzebuje przeglądów i przezbrojeń
Modele wdrożone w logistyce produkcji mają tendencję do „starzenia się” – podobnie jak maszyny, które obsługują. Zmienia się miks produktów, dostawcy, strategie utrzymania ruchu, a nawet same systemy źródłowe. Jeśli nie ma czytelnej odpowiedzialności za przeglądy modeli, ich jakość spada, a zaufanie zespołu wraz z nią.
„Przegląd AI” jak przegląd linii produkcyjnej
Tak jak linie mają swoje postoje serwisowe, tak samo modele powinny mieć zaplanowane okna przeglądów. Nie chodzi tylko o techniczne retrainingi, ale również o pytania biznesowe:
- czy nadal optymalizujemy te same wskaźniki,
- czy zmieniła się struktura przestojów (np. więcej problemów jakościowych, mniej awarii mechanicznych),
- czy użytkownicy nie zaczęli obchodzić systemu (np. stale odrzucają rekomendacje w konkretnych scenariuszach).
Dobrym rytmem jest kwartalny przegląd strategiczny (z udziałem logistyki, utrzymania ruchu, planistów i IT/OT) oraz krótsze, techniczne przeglądy miesięczne. W wielu zakładach dopiero formalizacja takich cykli powoduje, że AI przestaje być „projektem” i staje się normalnym elementem infrastruktury decyzyjnej.
Śledzenie „dryfu rzeczywistości”
Modele uczą się na danych historycznych, które zawsze są trochę inne niż przyszłość. Gdy zmienia się miks klientów, pojawiają się nowe komponenty czy zmiany w łańcuchu dostaw, rozkłady prawdopodobieństw przestojów, awarii i opóźnień też się zmieniają. Jeśli system udaje, że świat jest wciąż taki jak rok temu, rekomendacje powoli tracą sensowność.
Rozwiązaniem jest monitorowanie prostych wskaźników „zdrowia modelu”:
- porównanie rozkładu nowych danych z tymi, na których model był uczony,
- regularna ocena trafności prognoz (np. przewidywanych ryzyk przestoju) na oknach ruchomych,
- analiza, w których segmentach procesu błąd rośnie najszybciej.
Gdy widać, że w określonym obszarze błąd stale rośnie, to sygnał do lokalnego „przezbrojenia” modelu – na przykład osobnego podejścia dla nowej rodziny produktów lub nowego dostawcy komponentów krytycznych. Lepiej mieć kilka prostszych, wyraźnie opisanych modeli niż jeden „uniwersalny”, który przestaje działać, gdy rzeczywistość zmieni się zbyt mocno.
Przy takim monitoringu nie trzeba zgadywać, czy model „jeszcze daje radę” – widać to w liczbach i w konkretnych przypadkach użycia. Czasem najlepszą decyzją nie jest kosztowny retraining rozbudowanego algorytmu, lecz świadome uproszczenie: zastąpienie części logiki prostymi regułami tam, gdzie proces się ustabilizował, i skupienie mocy obliczeniowej na obszarach o najwyższej zmienności.
Przeceniana jest także automatyczna adaptacja modeli. „Samouczące się” systemy brzmią dobrze w prezentacji, ale w środowisku produkcyjnym oznaczają realne ryzyko: model zaczyna reagować na przejściowe anomalie jak na nową normę. Bez ram decyzyjnych i bez kontroli wersji szybko powstaje chaos: nikt nie wie, dlaczego dzisiejsze rekomendacje różnią się od wczorajszych i czy to efekt poprawy, czy błędu.
Bezpieczniejszym podejściem jest kontrolowana ewolucja: najpierw model w trybie „shadow” działa równolegle z dotychczasowym, różnice są mierzone i omawiane na przeglądach, a dopiero potem następnik przejmuje sterowanie. Z biznesowego punktu widzenia ważniejsze jest utrzymanie stabilności procesu niż gonienie za pojedynczymi punktami procentowymi dokładności.
Kluczowe jest też to, by utrzymanie modeli nie było „sztuką tajemną” działu data science. Proste dashboardy stanu modeli, jasne kryteria, kiedy zgłosić problem (np. spadek skuteczności alarmów prewencyjnych poniżej określonego progu), oraz kanał do szybkiej wymiany informacji między halą a zespołem analitycznym robią większą różnicę niż kolejny wyszukany algorytm. AI, która starzeje się w ciszy, kończy jako ozdobnik w prezentacjach, a nie narzędzie do realnego obniżania przestojów.
Największy efekt przychodów i oszczędności pojawia się tam, gdzie AI traktuje się jak element układu nerwowego fabryki: podłączony do realnych danych, okresowo diagnozowany, modyfikowany razem ze zmianą strategii i layoutu. W takiej konfiguracji sztuczna inteligencja nie zastępuje zdrowego rozsądku ludzi z produkcji i logistyki, tylko pozwala im wcześniej widzieć ryzyko i precyzyjniej decydować, gdzie kolejny przestój zamieni się w kontrolowany, krótszy postój zamiast w kosztowną awarię całego systemu.
Najczęściej zadawane pytania (FAQ)
Jakie są najważniejsze zastosowania sztucznej inteligencji w logistyce produkcji?
AI w logistyce produkcji najczęściej wykorzystuje się do trzech obszarów: redukcji przestojów (predykcyjne utrzymanie ruchu i lepsze planowanie postojów), optymalizacji zapasów (prognozowanie popytu, poziomów bezpieczeństwa, rotacji komponentów) oraz usprawnienia logistyki wewnętrznej (planowanie tras wózków, kolejkowanie zleceń transportowych, eliminacja „pustych przebiegów”).
Do tego dochodzi optymalizacja harmonogramów produkcji: AI układa sekwencje zleceń tak, aby zminimalizować liczbę przezbrojeń, zsynchronizować dostępność materiałów i ludzi oraz uniknąć „pustych okien” na liniach. Klucz nie polega na fajerwerkach technologicznych, lecz na wpięciu modeli w konkretne decyzje dnia codziennego.
Od czego zacząć wdrażanie AI w logistyce produkcji, jeśli mamy ograniczony budżet?
Zamiast myśleć o „transformacji cyfrowej całej fabryki”, lepiej zacząć od dwóch kroków: najpierw policzyć, gdzie realnie uciekają pieniądze (przestoje, nadgodziny, zakupy awaryjne, złom), a potem wybrać 1–2 wąskie gardła, w których strata jest największa i najczęstsza. Przykładowo: linia o najwyższym wolumenie, strefa przyjęć zewnętrznych, magazyn części zamiennych.
Przy małym budżecie sens mają małe, „skrojone” modele: np. prosty model predykcyjnego serwisu dla jednej krytycznej maszyny albo system rekomendujący krótkie, dodatkowe dostawy dla kilku kluczowych komponentów. Dopiero kiedy w tych punktach widać spadek przestojów lub zapasów, opłaca się skalować rozwiązanie szerzej.
Jakie dane są potrzebne, żeby AI w logistyce produkcji miała sens?
Nie chodzi o „jak najwięcej danych”, tylko o dane powiązane z konkretnymi decyzjami. W praktyce najważniejsze są: historia przestojów i awarii (z przyczynami), stany i ruchy magazynowe, czasy realizacji zleceń, dane z maszyn i czujników (jeśli są), harmonogramy pracy ludzi i linii oraz informacje o opóźnieniach dostaw od dostawców.
Nawet jeśli dane są rozproszone między ERP, MES, CMMS i arkusze Excela, można zacząć od integracji minimum potrzebnego pod wybrany problem. Typowy błąd to próba „uporządkowania wszystkich danych w całej firmie” przed pierwszym projektem AI. Często lepiej zbudować pierwszy model na nieidealnych, ale wystarczająco dobrych danych z jednego obszaru, a dopiero potem porządkować resztę.
Czy AI w logistyce produkcji wymaga dużych inwestycji w nowe maszyny i systemy?
Nie zawsze. W wielu fabrykach sensowne efekty przynoszą projekty, które korzystają wyłącznie z tego, co już jest: istniejący ERP/MES, podstawowe czujniki na maszynach, dane z raportów OEE, zapisy przestojów w CMMS. Przykładowy model, który wykrywa rosnącą wibrację lub temperaturę przed awarią, można zbudować na obecnej infrastrukturze, o ile dane są rejestrowane i dostępne.
Duże inwestycje w dodatkową automatyzację i IoT mają sens dopiero wtedy, gdy wiadomo, które decyzje chcesz zautomatyzować i jakich danych faktycznie brakuje. Odwrotna kolejność – najpierw kupmy technologię, potem wymyślajmy zastosowania – zwykle kończy się drogimi „pilotażami na pokaz”, a nie spadkiem przestojów czy kosztów.
Jak zmierzyć, czy wdrożenie AI faktycznie zmniejsza przestoje i koszty?
Najpierw trzeba zdefiniować kilka prostych, twardych wskaźników dla wybranego obszaru: np. łączny czas przestojów na linii, liczba nieplanowanych zatrzymań, godziny nadliczbowe w danym gnieździe, średni poziom zapasu dla kluczowych komponentów, liczba „awaryjnych” zakupów. Bez takiej linii bazowej każdy projekt AI będzie można „uznać za sukces” lub „uznać za porażkę” wyłącznie na poziomie opinii.
Dopiero potem włącza się rozwiązanie AI i przez kilka tygodni lub miesięcy porównuje stan „przed” i „po”, pilnując, żeby nie mieszać zmian (np. zmiana organizacji zmian + nowy model AI). Dobrą praktyką jest krótki okres, w którym AI jedynie rekomenduje działania, a człowiek decyduje – to pozwala zrozumieć, kiedy algorytm pomaga, a kiedy daje fałszywe alarmy.
Dlaczego podejście „automatyzujmy wszystko” często się nie sprawdza w logistyce produkcji?
Szerokie programy automatyzacji i „AI wszędzie” rozpraszają uwagę i budżet: zespoły IT i utrzymania ruchu gonią za wieloma wątkami, a na hali nie widać szybkich, wymiernych korzyści. Efekt uboczny to zmęczenie zmianą – pracownicy widzą nowe narzędzia, ale wciąż mają nadgodziny, czekają na materiał i szukają pojemników.
Lepszym podejściem jest uderzenie w 2–3 wąskie gardła z największym wpływem na marżę. Jeśli na jednej linii uda się skrócić przestoje o kilkanaście procent dzięki prostemu modelowi predykcyjnemu, łatwiej przekonać załogę i zarząd do kolejnych kroków niż setką slajdów o „fabryce 4.0”. Automatyzacja „wszystkiego” ma sens dopiero wtedy, gdy wiadomo, które elementy naprawdę generują zysk.
Jak przekonać pracowników produkcji i logistyki do korzystania z rozwiązań AI?
Technologia zwykle nie jest głównym problemem – opór rodzi się, gdy ludzie widzą kolejne narzędzie, ale nie widzą, co z niego mają. Najprościej pokazać bardzo konkretną zmianę: mniej nocnych telefonów do utrzymania ruchu, krótsze poszukiwania brakujących komponentów, mniejszą liczbę nagłych zmian planu na zmianie.
Dobrze działa podejście, w którym brygadziści i operatorzy są włączeni w projekt od początku: pomagają zdefiniować problem, weryfikują alarmy modelu, komentują rekomendacje. Zamiast hasła „AI was zastąpi”, komunikat jest inny: „AI ma wcześniej ostrzegać o kłopotach, żebyście nie gasili pożarów w ostatniej chwili”. W praktyce to często decyduje o tym, czy system będzie używany, czy tylko „zainstalowany”.
Co warto zapamiętać
- Logistyka produkcji jest naturalnym obszarem dla AI, bo przypomina gęstą sieć naczyń połączonych – drobne zakłócenie w dostawie, przezbrojeniu czy transporcie wewnętrznym szybko zamienia się w twardy koszt przestojów, nadgodzin i błędów.
- Problemem nie jest brak danych, lecz ich rozproszenie i „raportowy” charakter – ERP, MES, CMMS, Excelle i wiedza brygadzistów działają obok siebie, zamiast zasilać bieżące decyzje operacyjne.
- AI daje przewagę nie przez „magiczne algorytmy”, ale dzięki łączeniu strumieni danych z wielu systemów i wykrywaniu subtelnych wzorców, które zapowiadają nadchodzące kłopoty (opóźniony transport, rosnące ryzyko awarii, zator materiałowy).
- Największe straty to nie spektakularne awarie, tylko ciche dreny marży: setki mikroprzestojów, nadprodukcja i przewymiarowane zapasy, chaotyczne harmonogramy oraz nieuporządkowana logistyka wewnętrzna – AI pozwala je namierzyć i policzyć.
- Szerokie programy „zautomatyzujmy wszystko” często zawodzą, bo rozmywają wysiłek i nie dają szybkich efektów na hali; lepsza jest koncentracja na 2–3 wąskich gardłach, gdzie każdy procent poprawy natychmiast widać w kosztach i dostępności linii.
- Małe, dobrze osadzone w procesie modele AI (np. predykcja awarii na podstawie wibracji) potrafią przynieść większą wartość niż rozbudowane projekty – pod warunkiem, że są spięte z istniejącymi procedurami i realnymi decyzjami utrzymania ruchu czy logistyki.